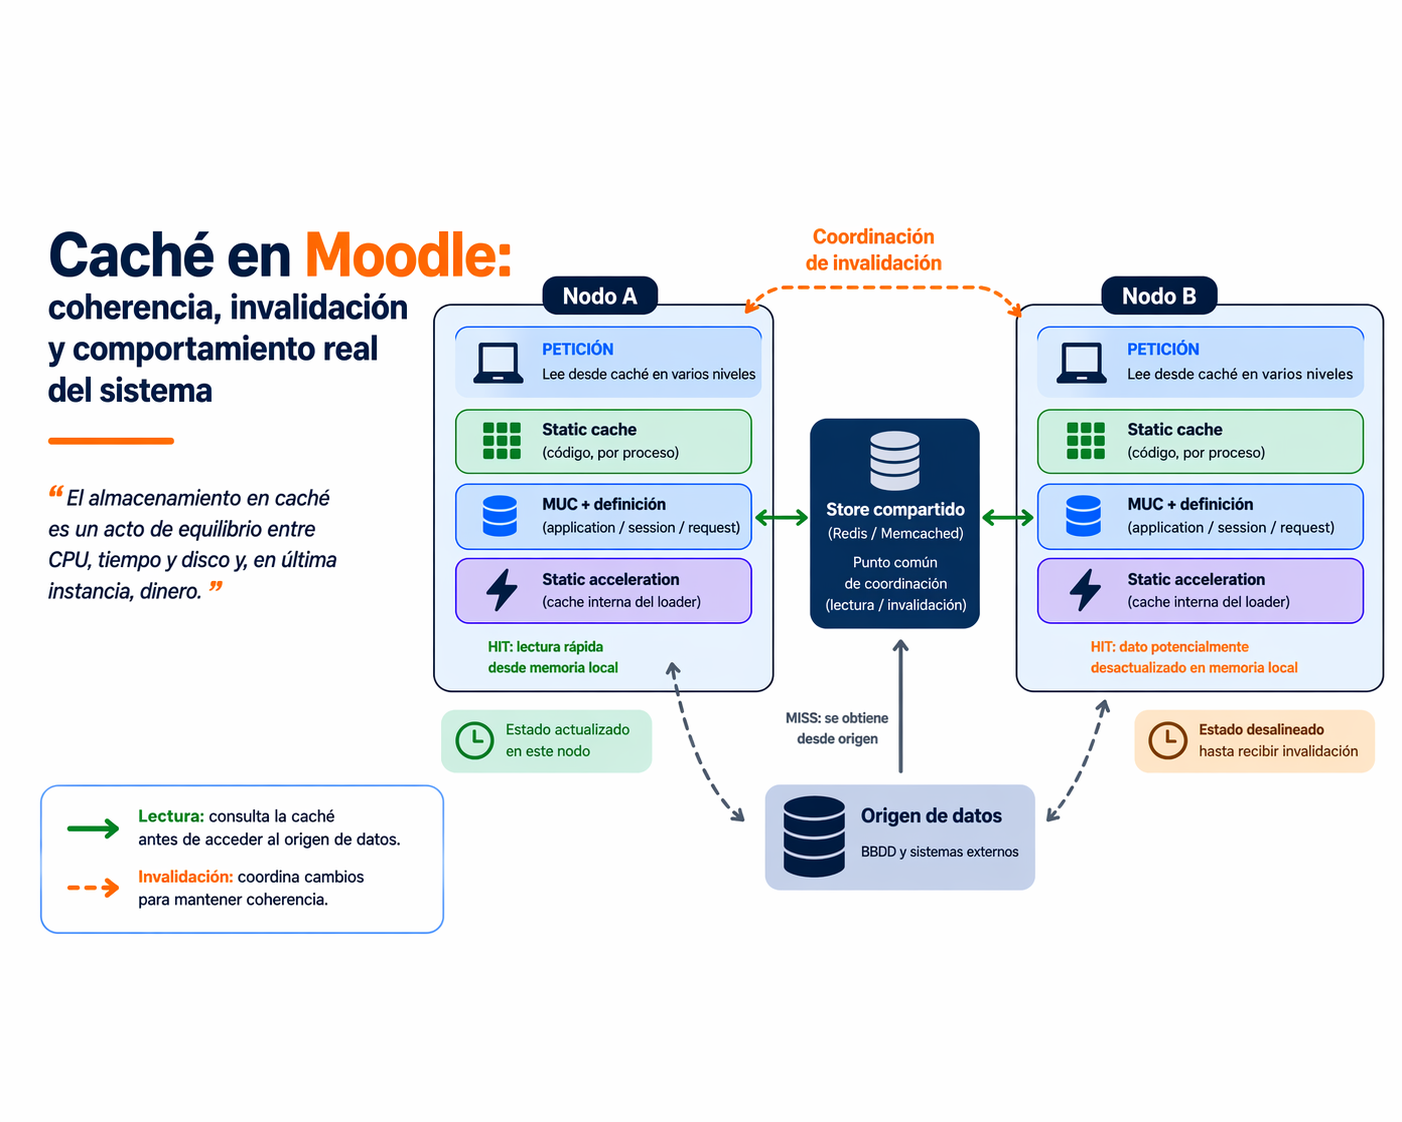
"El almacenamiento en caché es un acto de equilibrio entre CPU, tiempo y disco y, en última instancia, dinero."
Detrás de esa frase hay algo más que una decisión de rendimiento, porque en una plataforma Moodle que ya opera con cierto volumen la caché forma parte del comportamiento del sistema, condicionando la coherencia de los datos, la latencia percibida y la forma en la que la plataforma responde bajo carga.
Hablar de caché en este contexto implica hablar de arquitectura y de cómo el sistema se mantiene estable en el tiempo.
Por qué la caché deja de ser un detalle técnico
En una instalación pequeña, la caché suele mantenerse en un segundo plano, ya que el sistema responde con normalidad, las páginas cargan sin fricciones y, más allá de algún purgado ocasional, no parece necesario prestarle demasiada atención.
A medida que la plataforma crece, empiezan a aparecer comportamientos más difíciles de interpretar si no se tiene en cuenta esta capa. Operaciones que se ejecutan correctamente pero cuyos efectos tardan en reflejarse, nodos que muestran estados distintos durante intervalos breves, cambios que requieren purgar caché para hacerse visibles o errores intermitentes que desaparecen tras una limpieza sin que la causa quede del todo clara.
En este escenario, la caché empieza a integrarse de forma natural en el análisis del sistema, al participar directamente en cómo se materializan estos comportamientos.
Qué es realmente la MUC
Moodle introduce la Moodle Universal Cache (MUC) como una capa unificada para gestionar el almacenamiento en caché dentro del sistema, permitiendo abstraer tanto el tipo de dato como el backend y las condiciones bajo las que se accede a él.
Desde el punto de vista de desarrollo, trabajar con caché implica definir qué se almacena, dónde se almacena (memoria, disco, Redis, etc.) y bajo qué alcance se utiliza (application, session, request), que determina cómo se comporta esa caché dentro del sistema.
Las definiciones de caché actúan además como un contrato dentro del sistema, ya que centralizan las decisiones sobre cómo se almacena y se accede a la información, incluyendo su ciclo de vida, invalidación y condiciones de uso. Esto permite que cualquier parte del código que utilice esa caché lo haga bajo las mismas reglas, independientemente del contexto.
En algunos casos, esta responsabilidad no recae en el código consumidor, sino en la propia definición de caché mediante el uso de un data source. Bajo este enfoque, una lectura que no encuentra el dato puede resolverse automáticamente a través de la capa de caché, que se encarga tanto de obtenerlo como de almacenarlo, simplificando el consumo a costa de desplazar la responsabilidad de coherencia e invalidación hacia la propia definición.
Un ejemplo sencillo, tomado del core, podría ser el siguiente:
La lectura es sencilla, aunque ese acceso depende de decisiones previas sobre la validez del dato, su ciclo de vida y cómo se mantiene alineado con el estado real del sistema.
Tipos de caché y alcance real
Moodle distingue varios tipos de caché en función de su alcance y de cómo se comparte la información.
La application cache puede compartirse entre procesos y, si se utiliza un store compartido como Redis o Memcached, también entre nodos. Este comportamiento no depende del tipo de caché en sí, sino del store configurado.
La session cache queda vinculada a la sesión de usuario, lo que introduce un ámbito más acotado.
La request cache existe únicamente durante la ejecución de una petición concreta, lo que limita su impacto temporal.
Coherencia y coste de acceso a datos
Cada decisión de caché introduce una relación entre el coste de obtener un dato y el nivel de coherencia que se desea mantener en el sistema, lo que obliga a contextualizar cada caso según el uso de esa información.
Los datos derivados o agregados suelen admitir cierto grado de desactualización sin impacto significativo, mientras que estados críticos como permisos, matriculaciones o flags de negocio requieren una coherencia mucho más estricta para evitar comportamientos inesperados.
Las integraciones externas añaden otra variable, ya que sus latencias o inconsistencias pueden trasladarse directamente a la caché si no se tiene en cuenta su naturaleza.
La dificultad aparece cuando estas decisiones no se hacen explícitas, ya que la caché empieza a comportarse de forma aparentemente errática sin que exista un criterio claro detrás.
En determinados contextos, la caché pasa a actuar como una fuente de verdad temporal, ya que durante ciertos intervalos es la información cacheada la que define el comportamiento observable del sistema, incluso cuando no coincide completamente con el estado persistido.
Invalidación, el punto más delicado
Dentro de cualquier sistema de caché, la invalidación concentra buena parte de la complejidad, porque define cuándo un dato deja de ser válido y qué mecanismos deben intervenir para mantener la coherencia.
En Moodle, esto se traduce en identificar qué eventos afectan al dato cacheado, cómo se gestiona esa invalidación en el sistema y qué ocurre si no se ejecuta en el momento adecuado.
Un patrón habitual consiste en cachear resultados sin definir con precisión su ciclo de vida, lo que inicialmente funciona sin fricciones pero termina generando inconsistencias difíciles de reproducir.
Un caso sencillo permite ilustrarlo. Se cachea una lista de usuarios, se modifica una matrícula y el sistema continúa devolviendo la versión anterior durante un tiempo indefinido. No aparece ningún error explícito, pero el estado del sistema deja de reflejar la realidad.
En algunos casos, la invalidación no se gestiona eliminando directamente los datos cacheados, sino mediante el uso de versiones o revisiones. En este enfoque, el dato cacheado queda asociado a una versión concreta y, cuando esta cambia, las lecturas dejan de considerar válidos los valores anteriores. Este patrón es habitual en Moodle y permite simplificar la invalidación a costa de mantener datos obsoletos durante un tiempo hasta que expiran o son reemplazados.
La invalidación también puede articularse a través de eventos que las definiciones de caché pueden declarar como desencadenantes de invalidación, lo que permite coordinar la coherencia entre distintas partes del sistema, aunque introduce un coste adicional al requerir recorrer las definiciones afectadas y aplicar la invalidación en cada una de ellas.
Caché en entornos distribuidos
Cuando la plataforma se ejecuta sobre varios nodos, la gestión de la caché introduce una capa adicional de complejidad que depende en gran medida del tipo de store utilizado.
Los stores en memoria o en filesystem no compartido, como APCu o un file store sobre disco local, mantienen una copia independiente en cada nodo, lo que puede generar diferencias temporales en el estado del sistema. A esto se suma el uso de static cache a nivel de código, limitada a cada proceso y ajena a la MUC.
La propia MUC puede introducir además mecanismos de cacheo en memoria dentro del proceso, como la static acceleration, que mantiene en memoria los datos utilizados durante la ejecución para evitar accesos repetidos a los stores. Este comportamiento mejora el rendimiento, pero añade otra capa de estado local que no participa en la coherencia entre nodos.
En la práctica, estas capas no operan de forma aislada, sino que se combinan. Una misma lectura puede resolverse desde la static cache del propio código, desde la static acceleration de la MUC o desde el store configurado. Esta superposición mejora el rendimiento, pero introduce múltiples puntos donde el estado puede divergir si no se gestiona correctamente la invalidación.
Los stores compartidos, como Redis o Memcached, permiten centralizar la caché, reduciendo las divergencias entre nodos a costa de introducir latencia de red y dependencia de un servicio externo.
En este tipo de entornos aparece además un patrón habitual en Moodle, combinar una caché compartida con cachés locales en cada nodo. De esta forma, las lecturas se resuelven en memoria local con baja latencia, mientras que el sistema compartido actúa como punto de coordinación para las invalidaciones. Este tipo de configuraciones están soportadas por la propia MUC, que permite utilizar almacenamiento local en determinadas definiciones (por ejemplo, mediante la opción canuselocalstore en la definición de caché) cuando el modelo de coherencia lo permite. Casos como modinfo o el sistema de capacidades ilustran este enfoque, resolviendo lecturas desde memoria local y utilizando mecanismos globales para invalidar el estado cuando se producen cambios.
Este enfoque mejora el tiempo de respuesta y mantiene un grado razonable de coherencia global, aunque no evita completamente que distintos nodos puedan trabajar con estados ligeramente distintos durante breves intervalos.
Estas diferencias hacen que una misma implementación pueda comportarse de forma distinta entre un entorno de desarrollo y un entorno de producción, donde la distribución del sistema empieza a tener un peso real.
Problemas habituales en proyectos reales
En plataformas con cierto recorrido, es posible encontrar patrones relacionados con la caché que condicionan el comportamiento del sistema, como:
- Cachés definidas sin una estrategia clara de invalidación.
- Uso de static cache sin considerar ejecuciones prolongadas, donde los datos pueden permanecer en memoria más allá del ciclo esperado.
- Dependencia de purgados manuales como mecanismo habitual de resolución.
- Diferencias de comportamiento entre entornos que dificultan el diagnóstico.
- Cachés que terminan ocultando problemas de rendimiento en lugar de abordarlos.
En muchos de estos casos, las decisiones que han dado forma a la caché terminan reflejándose en estos comportamientos, lo que dificulta identificar el origen si no se analiza el sistema en conjunto.
Pensar la caché como parte del sistema
La caché en Moodle forma parte de cómo el sistema calcula, distribuye y mantiene sus datos a lo largo del tiempo, lo que implica que cada decisión sobre qué cachear, durante cuánto tiempo y bajo qué condiciones invalidarlo introduce un comportamiento concreto en la plataforma.
Estas decisiones terminan afectando tanto a la operación diaria como a la capacidad de evolución del sistema, especialmente cuando el volumen crece y las condiciones dejan de ser ideales.
En ese contexto, la diferencia no está únicamente en el tiempo de respuesta, sino en la capacidad del sistema para ofrecer información que siga siendo consistente con su estado real.
Documentación oficial para profundizar
Para quien quiera revisar el funcionamiento en detalle o contrastar implementaciones concretas, la documentación oficial de Moodle cubre la Cache API desde distintos ángulos:
- Cache API (visión completa del subsistema) 🔗 https://moodledev.io/docs/5.2/apis/subsystems/muc
- Quick reference (resumen práctico de uso) 🔗 https://docs.moodle.org/dev/Cache_API_-_Quick_reference
- Definición y configuración de cachés en Moodle 🔗 https://docs.moodle.org/501/en/Caching
- README de caché en el core (visión más cercana a implementación) 🔗 https://github.com/moodle/moodle/blob/3fd359b05ab9a42a9185059efe3c46fab980bad0/public/cache/README.md