En los dos artículos anteriores revisábamos primero la lógica arquitectónica del Task API y después su implementación dentro de un plugin. En ambos artículos aparece una idea de fondo. Las tareas no son un detalle técnico secundario, forman parte del comportamiento real del sistema.
Ese papel de las tareas dentro del comportamiento del sistema se vuelve especialmente relevante cuando la plataforma crece.
Mientras el volumen es pequeño, el sistema de tareas suele percibirse como estable por inercia. El cron se ejecuta, las colas avanzan y rara vez hace falta mirar más allá. A medida que aumentan los cursos, las matrículas, las integraciones y las operaciones diferidas, la situación cambia. A partir de cierto punto, el estado del sistema de tareas condiciona la operación de la plataforma.
En ese contexto, la atención está en la capacidad del sistema para absorber el trabajo pendiente con una latencia razonable y con un impacto asumible sobre el resto de la plataforma.
Cuando el cron sigue ejecutándose, pero el sistema ya no responde igual
En Moodle, que el cron esté ejecutándose no aporta por sí mismo información suficiente sobre el estado del sistema de tareas. Su funcionamiento forma parte del comportamiento esperado, pero no garantiza que la carga pendiente se esté procesando al ritmo adecuado.
En equipos de operaciones, revisar el estado del cron, las colas y los logs debería formar parte del seguimiento habitual de la plataforma, especialmente en entornos con volumen. Ese seguimiento permite entender cómo evoluciona la carga y anticipar posibles desajustes.
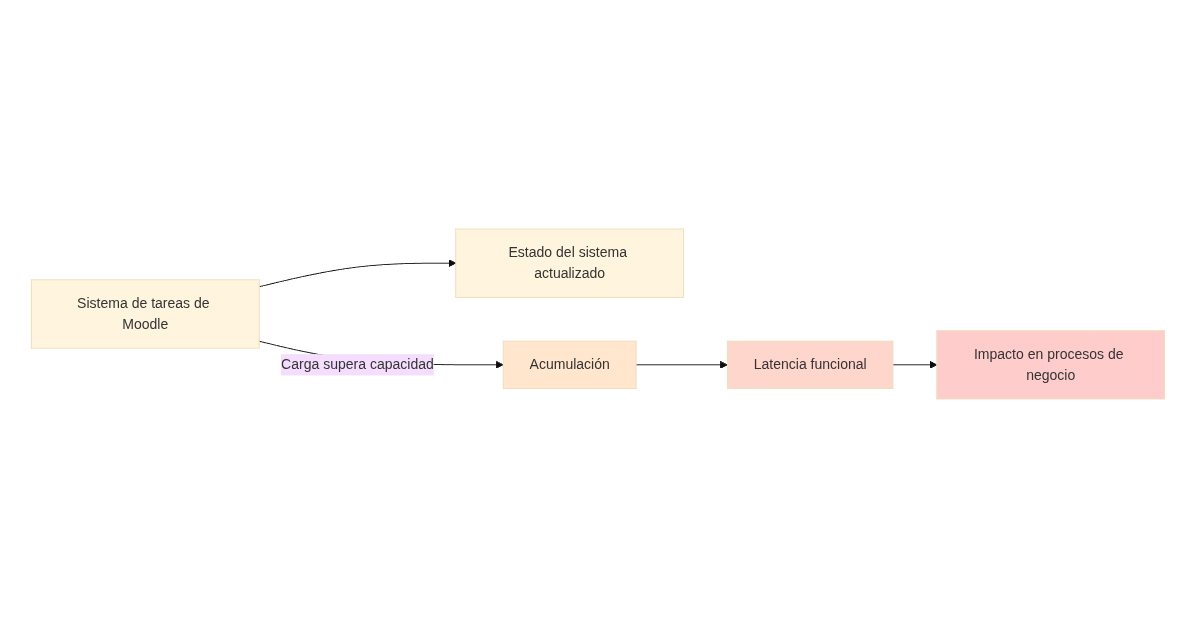
A partir de ahí, la atención se sitúa en la relación entre la carga que se genera y la capacidad del sistema para procesarla de forma sostenida. Cuando la capacidad deja de acompañar al ritmo de generación de trabajo, el sistema empieza a degradarse.
En entornos con cierto volumen, esa degradación rara vez se manifiesta como una interrupción completa. Suele aparecer de forma progresiva en distintos puntos del sistema.
- las adhoc tasks empiezan a acumularse,
- algunas tareas periódicas se ejecutan cada vez más tarde,
- aparecen retrasos en notificaciones, sincronizaciones o procesos de generación,
- la base de datos soporta picos más largos y menos predecibles,
- el equipo empieza a percibir síntomas dispersos que no siempre se relacionan con el sistema de tareas en un primer momento.
Desde fuera puede parecer que la plataforma funciona más lenta o que determinadas funciones tardan más de lo habitual. En realidad, el sistema de ejecución diferida no está absorbiendo el trabajo pendiente con la regularidad esperada, y ese retraso empieza a afectar directamente a cómo se comportan los procesos de negocio sobre la plataforma.
La cola como indicador de salud del sistema
Ese comportamiento no siempre es evidente a simple vista, pero deja señales claras si se observa el sistema desde el punto adecuado.
Cuando una plataforma depende de la ejecución diferida para parte de su funcionamiento, la cola pendiente es uno de los puntos donde ese comportamiento se puede observar de forma directa.
No basta con observar cuántas tareas están esperando. Resulta más útil atender a su antigüedad, al ritmo de entrada y a la velocidad de resolución.
Una cola de cien tareas puede ser irrelevante en una instalación y una señal preocupante en otra. Todo depende del tipo de trabajo que representan y del tiempo que permanecen pendientes.
La lectura operativa está en cómo evolucionan esas métricas en el tiempo. Si la antigüedad crece, si el volumen pendiente se estabiliza o aumenta, o si el ritmo de resolución no acompaña al de entrada, la cola empieza a reflejar una presión sostenida sobre el sistema.
La cola permite observar cómo está respondiendo el sistema ante la carga que está asumiendo.
El problema no siempre está en la task que falla
Cuando se investiga una degradación del sistema de tareas, es habitual centrarse en localizar una tarea que esté fallando.
Ese enfoque puede ser útil en algunos casos, aunque en producción muchas incidencias no se originan en errores explícitos. Aparecen en tareas que terminan correctamente y, aun así, consumen más recursos de los que el sistema puede absorber con normalidad.
Una scheduled task que recorre demasiados registros en cada ejecución puede no lanzar ninguna excepción y seguir generando un problema relevante. Una adhoc task que depende de un servicio externo con latencias variables puede completar su trabajo y, aun así, introducir un cuello de botella. Una cadena de tareas pequeñas puede parecer inofensiva en desarrollo y convertirse en una fuente constante de carga cuando el volumen real multiplica el número de inserciones en cola.
El diagnóstico útil no consiste únicamente en identificar errores. Requiere entender qué tareas dominan el tiempo total de ejecución, cuáles generan mayor presión sobre la base de datos y cuáles tienen capacidad de amplificar retrasos en procesos posteriores. Para poder hacerlo con criterio, es necesario conocer cómo está construida la plataforma, qué tareas forman parte de su funcionamiento habitual, de qué integraciones depende y qué zonas concentran mayor carga o mayor sensibilidad operativa. Sin ese contexto, el análisis tiende a quedarse en síntomas aislados y resulta más difícil anticipar el comportamiento del sistema bajo condiciones reales.
Latencia funcional y percepción de la plataforma
Una de las razones por las que estos comportamientos tardan en detectarse es que la latencia de las tareas no siempre se refleja en la interfaz.
En muchos casos, además, el sistema de tareas no está sujeto a una observación continua. No siempre existen alertas útiles, los avisos pueden resultar excesivos o poco accionables y, con el tiempo, dejan de revisarse con la frecuencia necesaria. Sin un seguimiento operativo sostenido, la degradación puede avanzar durante horas o días antes de hacerse evidente.
La persona usuaria realiza una acción y la página responde con normalidad. Desde su punto de vista, la operación se ha completado. Sin embargo, parte del trabajo real puede haberse delegado al sistema de tareas, que en ese momento ya está saturado.
La interacción funciona, pero el resultado queda condicionado por el estado de la cola. Cuando existe retraso en la ejecución diferida, termina trasladándose a la experiencia real del proceso de negocio.
Organización de la carga y criticidad de las tareas
En instalaciones medianas o grandes conviene asumir que no todas las tareas tienen el mismo peso operativo.
Algunas sostienen funciones críticas del negocio, mientras que otras resuelven procesos secundarios o diferibles. Cuando todo ese trabajo comparte el mismo canal de ejecución sin criterios claros de organización, la plataforma termina tratando con el mismo nivel de prioridad operaciones que tienen impactos muy distintos.
Este tipo de diseño está fuertemente condicionado por el margen de capacidad disponible. A medida que ese margen se reduce, la plataforma empieza a tener más dificultades para absorber determinadas cargas.
En ese momento, la acumulación de trabajo accesorio puede retrasar procesos sensibles para la organización sin que exista necesariamente un fallo evidente. Basta con que el sistema no tenga mecanismos para aislar o amortiguar determinadas cargas.
A partir de aquí, el Task API queda directamente vinculado a decisiones arquitectónicas relacionadas con la operación, que se concretan en aspectos como los siguientes:
- separación entre nodos web y nodos de tareas,
- control de concurrencia,
- aislamiento de procesos costosos,
- revisión del impacto de integraciones externas,
- evaluación de qué procesos deben seguir ejecutándose dentro de Moodle y cuáles conviene desplazar fuera del propio sistema de tareas.
En este último caso, no se trata de asumir que determinadas cargas deban ejecutarse fuera de Moodle por defecto, sino de analizar cada situación en función de su comportamiento, su coste y su impacto en la operación. Algunas operaciones pueden resolverse de forma más eficiente fuera del entorno de ejecución de Moodle, mientras que otras encajan mejor dentro de su propio modelo de ejecución.
A partir de aquí, la atención está en la capacidad del sistema y en cómo se gestiona la carga.
Reintentos automáticos y su efecto en la operación
El mecanismo de reintento de Moodle resulta útil ante fallos transitorios, ya que permite recuperar ejecuciones sin intervención manual.
Su efecto depende del tipo de fallo.
Cuando el fallo es temporal, el reintento ayuda a resolver la situación; en fallos persistentes, ya sea por datos inconsistentes, errores lógicos o dependencias externas degradadas, los reintentos generan tráfico repetido, aumentan los logs y añaden presión sobre la cola.
En ese escenario, el sistema acumula ejecuciones repetidas sin capacidad efectiva de resolver la causa del fallo.
En equipos de operaciones, conviene distinguir qué tareas pueden beneficiarse de reintentos automáticos y cuáles requieren intervención o aislamiento cuando fallan de forma reiterada.
Visibilidad del sistema en operación
El seguimiento del sistema de tareas resulta mucho más manejable cuando existe una mínima visibilidad sobre su estado.
No hace falta una plataforma de monitorización compleja para trabajar con señales útiles. En muchos casos es suficiente con disponer de información que permita entender cómo se está comportando el sistema:
- cuántas tareas hay pendientes,
- desde cuándo están esperando las más antiguas,
- qué tareas consumen más tiempo,
- cuáles fallan con mayor frecuencia,
- qué procesos generan más volumen de trabajo,
- si el cron se ejecuta con la regularidad esperada.
Esta información puede integrarse en herramientas ya existentes dentro del equipo, incorporarse a paneles de seguimiento o recogerse mediante scripts sencillos que permitan revisar el estado del sistema de forma periódica. Lo importante es que forme parte de la operativa habitual y no dependa de una revisión puntual cuando aparece una incidencia.
Sin esta visibilidad, el análisis tiende a apoyarse en señales parciales y a llegar tarde.
Diseño técnico y carga operativa
Quien implementa una task está definiendo parte de la carga operativa futura de la plataforma, aunque no siempre se tenga en cuenta.
Decisiones como el tamaño de lote, la forma de encolar trabajo, la gestión de fallos parciales, el nivel de detalle en logs o la dependencia de servicios externos dentro de bucles forman parte del desarrollo. Al mismo tiempo, configuran el comportamiento operativo del sistema y condicionan cómo va a responder la plataforma cuando el volumen crezca o cambien las condiciones.
Con el tiempo, la acumulación de tareas bien implementadas de forma individual acaba generando un sistema cuyo comportamiento resulta difícil de anticipar.
Este tipo de deuda rara vez aparece en revisiones funcionales. Suele manifestarse meses después, cuando cambian los volúmenes, se incorporan nuevas integraciones o se reduce la ventana operativa disponible.
Pensar el Task API como parte de la plataforma
A lo largo de esta serie hemos visto el Task API desde su diseño hasta su comportamiento en producción. En ese recorrido, las tareas se entienden como parte del funcionamiento real de la plataforma, más allá de un mecanismo auxiliar.
Esa forma de entender el sistema tiene implicaciones tanto en el diseño de los plugins como en la forma de operar la plataforma.
La implementación de cada task deja de ser un detalle aislado y se interpreta en términos de comportamiento del sistema y de respuesta ante la carga.
La estabilidad está condicionada por lo que ocurre durante una request, por la evolución del trabajo pendiente y por la capacidad del sistema para absorberlo con una latencia razonable.